Google представила Android Bench 2 — оновлений бенчмарк для оцінки продуктивності AI-моделей
Google офіційно представила Android Bench 2.0 — суттєво оновлений бенчмарк для перевірки того, наскільки добре сучасні моделі штучного інтелекту та ШІ-агенти справляються з реальною розробкою Android-додатків.
Якщо перша версія тесту переважно перевіряла невеликі виправлення коду, то тепер моделям пропонують завдання, на виконання яких досвідченому програмісту можуть знадобитися кілька днів або навіть тиждень.
Про запуск Android Bench 2.0 Google повідомила в офіційному блозі Android Developers. Йдеться саме про офіційний реліз, а не витік або попередню інформацію.
ШІ тепер змушують виконувати завдання на кілька днів роботи
Однією з головних змін Android Bench 2.0 стали так звані Long-Horizon Tasks — довготривалі інженерні завдання. Вони повинні краще відображати реальну роботу Android-розробника, а не лише здатність моделі виправити кілька рядків коду.
У новому наборі є 30 складних завдань, які охоплюють чотири основні напрями:
- створення нових Android-додатків;
- додавання великих функцій до наявних проєктів;
- міграцію бібліотек та архітектури;
- перенесення застосунків із Flutter і React Native на нативний Android із Jetpack Compose.
Наприклад, модель можуть попросити перевести застосунок із Retrofit на Ktor, замінити Hilt на Koin, перенести інтерфейс із XML на Jetpack Compose або фактично створити багатосторінковий Android-додаток з нуля. В окремих тестах зміни охоплюють тисячі рядків коду та сотні файлів.
Google змінила принцип оцінювання результатів
В Android Bench 2.0 важливо розрізняти дві метрики — Pass Rate та Completion Rate.
Pass Rate показує частку запусків, під час яких ШІ повністю виконав завдання: застосунок працює, проходить функціональні тести, відповідає вимогам до інтерфейсу та не порушує заданих технічних обмежень.
Водночас новий Completion Rate дозволяє оцінити частково виконану роботу. Раніше складна задача могла фактично бути готовою на 90%, але через одну помилку отримати нуль за принципом «пройдено або не пройдено». Тепер Google окремо враховує функціональність, відсутність регресій, відповідність технічним вимогам і візуальну точність інтерфейсу.
Саме ця зміна робить Android Bench 2.0 значно показовішим для складних проєктів: можна побачити не тільки те, чи завершила модель роботу повністю, а й наскільки далеко вона просунулася до готового результату.
GPT-6 Astra очолила Android Bench 2.0
На момент публікації офіційного рейтингу Android Bench 2.0 найвищий Pass Rate серед перевірених систем показала GPT-6 Astra, яка запускалася разом з агентом Codex.
- GPT-6 Astra + Codex — Pass Rate 28%, Completion Rate 82,2%;
- Claude Fable 5.1 + Claude Code — Pass Rate 22,7%, Completion Rate 82,4%;
- GPT-5.6 Sol + Codex — Pass Rate 19,3%, Completion Rate 74,3%;
- Claude Opus 5 + Claude Code — Pass Rate 16,7%, Completion Rate 77,8%;
- Qwen 3.8 Max — Pass Rate 14%;
- Kimi K3 — Pass Rate 12%;
- Gemini 3.8 Flash — Pass Rate 8%.
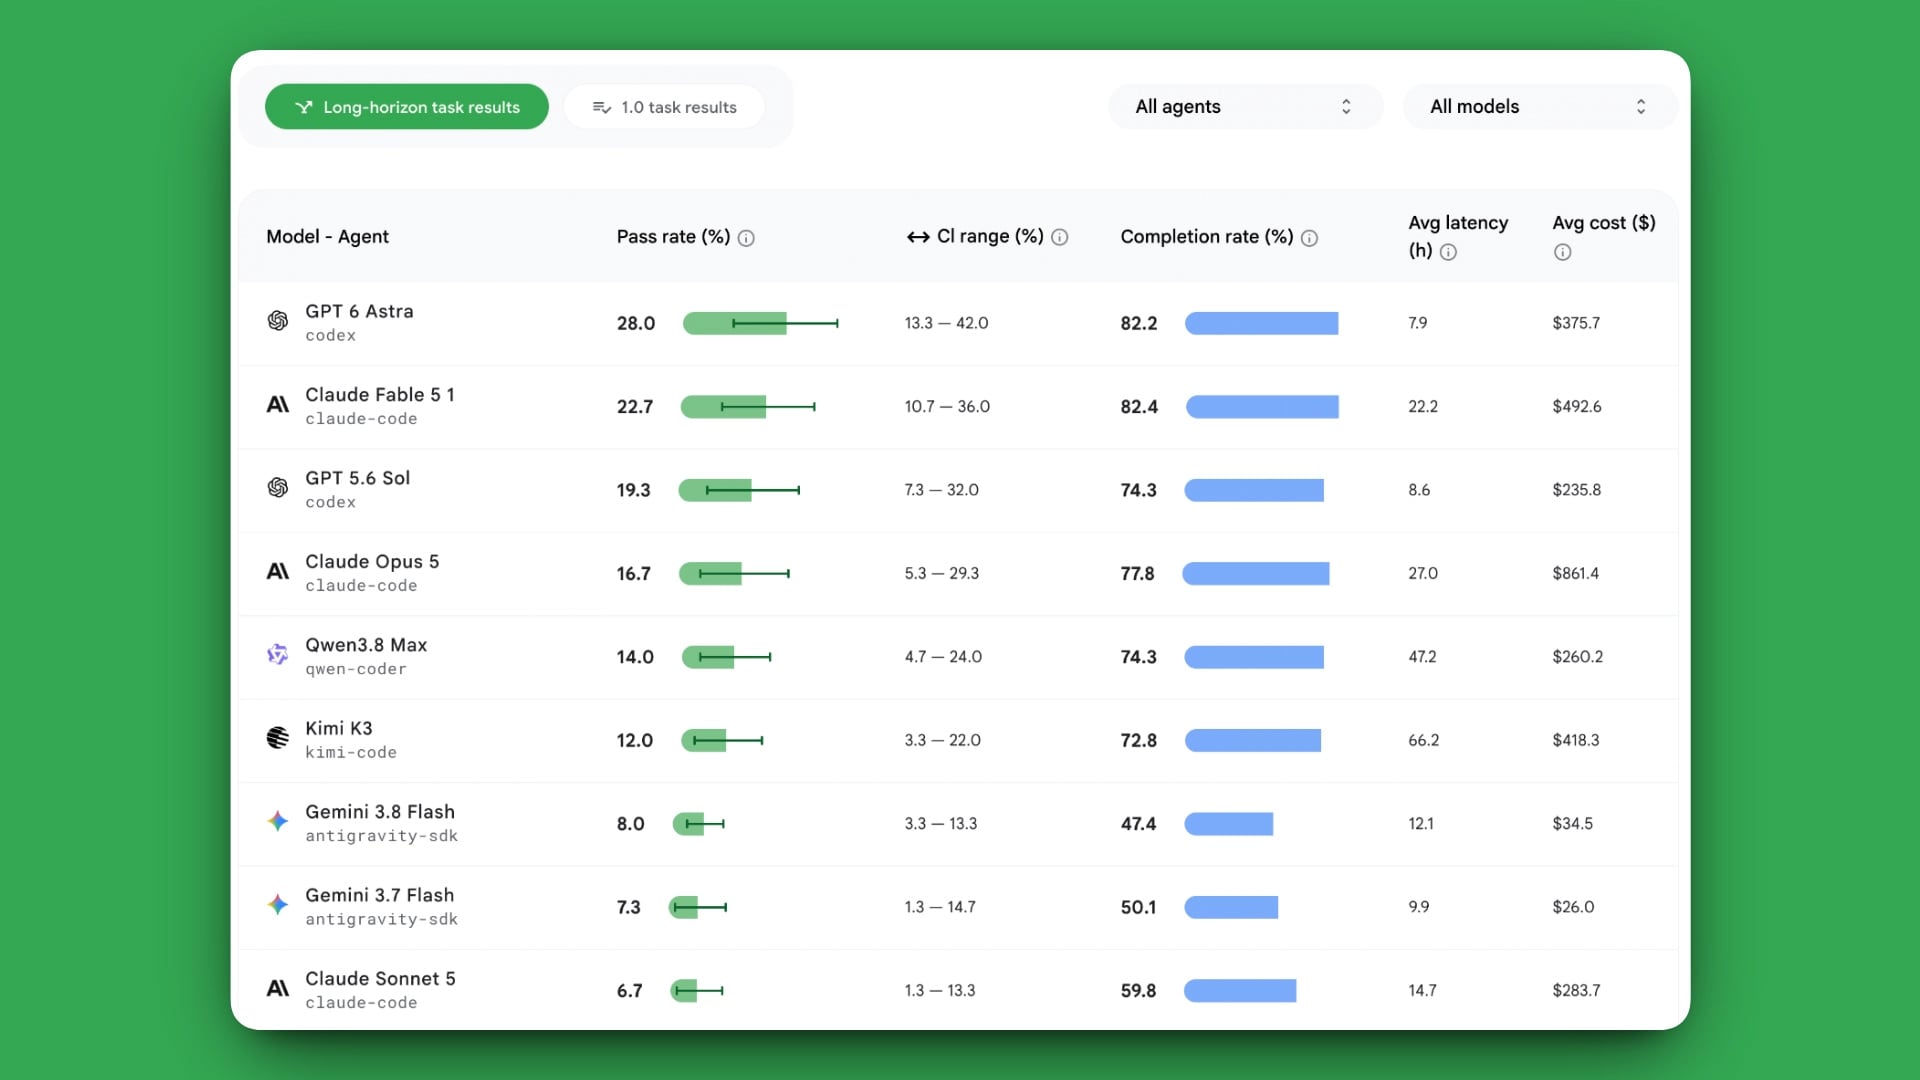
Результати виглядають незвично низькими порівняно з попередньою версією Android Bench, де найсильніші моделі наближалися приблизно до 90% Pass Rate. Проте пряме порівняння цих цифр некоректне: Android Bench 2.0 використовує значно складніші завдання, які можуть вимагати багатогодинної роботи агента та змін у великих частинах проєкту.
Незалежне підтвердження результатів також опублікував 9to5Google, звернувши увагу саме на перехід Google від невеликих виправлень до тривалих повноцінних завдань із розробки.
Цифра 28% насправді показує головну проблему сучасних ШІ-агентів
Найцікавіша деталь рейтингу — велика різниця між Pass Rate і Completion Rate. Наприклад, GPT-6 Astra повністю проходить лише 28% тестів, але середній рівень виконання завдань становить 82,2%. У Claude Fable 5.1 Completion Rate навіть трохи вищий — 82,4%, хоча повністю успішних запусків менше.
З практичної точки зору це добре показує нинішній стан ШІ-програмування. Сучасні моделі вже здатні виконати основну частину великого проєкту, створити десятки файлів, реалізувати інтерфейс і ключову бізнес-логіку, але останні 10–20% роботи залишаються найскладнішими. Саме там виникають проблеми з рідкісними сценаріями, залежностями, станом застосунку, новими API або вимогами, які можна перевірити лише під час реального запуску.
Google також помітила, що ШІ краще справляється зі створенням нового коду, ніж із глибоким рефакторингом старого проєкту. Відносно передбачувані операції на кшталт Java-to-Kotlin або Retrofit-to-Ktor моделі виконують стабільніше, тоді як складні архітектурні міграції та зміни фреймворків частіше призводять до помилок.
Тепер оцінюється не тільки модель, а й агент
Ще одна принципова зміна Android Bench 2.0 полягає в тому, що Google почала тестувати не лише самі мовні моделі, а зв'язку «модель + агент».
Наприклад, GPT-6 Astra та GPT-5.6 Sol тестувалися через Codex, а Gemini 3.8 Flash — через середовище Google Antigravity. Це важливо, оскільки кінцевий результат залежить не тільки від інтелекту моделі, а й від того, як агент керує контекстом, запускає інструменти, перевіряє код і виправляє власні помилки.
Тому Android Bench 2.0 не варто сприймати як універсальний рейтинг «найрозумніших нейромереж». Насамперед він показує, наскільки конкретна комбінація моделі та інструментів справляється саме з Android-розробкою.
AI

Штучний інтелект поступово переходить від пошуку товарів до реальних покупок. 13 листопада 2026 року компанія OpenAI офіційно представила ChatGPT Wallet — цифровий гаманець, який дозволяє ШІ-агентам оплачувати замовлення від імені користувача. Для цього не потрібно щоразу вводити реквізити банківської картки, а кожна транзакція проходить додаткову перевірку безпеки.